CVE-2026-43503: DirtyClone——一个bit遗失为什么会导致ubuntu被通杀
漏洞分析
DirtyClone(CVE-2026-43503)是 Linux 内核网络栈中的一个高危本地权限提升(LPE)漏洞。它属于 DirtyFrag 漏洞家族的变体,通过克隆网络数据包并操纵页面缓存(Page Cache)来实现免杀、无痕的提权。它在发布初期影响了几乎所有主流 Ubuntu 发行版。
背景知识 ---- 摘要 -- CVE-2026-43503 对应 Linux 内核提交 net: skbuff: propagate shared-frag marker through frag-transfer helpers。该问题表现为:若干仅迁移 skb 分片描述符的路径,在把 frags 从一个 sk\_buff 转移到另一个 sk\_buff 时,只复制了 skb\_shared\_info.frags 数组,没有同步 skb\_shared\_info.flags 中的 SKBFL\_SHARED\_FRAG。目标 skb 继续引用页缓存或外部页面,却对后续写路径报告这些分片为私有数据。ESP 输入路径在决定是否原地解密时会依据这一标志。标志丢失后,ESP 输入可以对共享页执行原地 AEAD 变换,最终改写 root 拥有、以只读方式打开的文件的页缓存。 本文先建立页缓存、splice 零拷贝、sk\_buff、SKBFL\_SHARED\_FRAG 和 GRO 的上下文,再分析 skb\_gro\_receive 中的具体缺陷,并给出该标志丢失后的完整利用路径。 ### 页缓存与 splice 零拷贝 Linux 文件系统通过页缓存保存文件内容。进程以 O\_RDONLY 打开一个 root 拥有的可读文件时,后续 read、mmap 或 splice 操作获得的是该文件页缓存中 struct page 的引用。普通进程即使没有写权限,也可以让内核把这些页缓存页交给 pipe 或 socket。 splice 和 sendfile 的关键语义在于迁移页引用,核心效果是避免逐字节复制数据。对于 sendfile,内核调用 do\_sendfile,再通过内部 pipe 调用 splice\_to\_socket;对于显式 splice,用户先把文件内容 splice 到 pipe,再把 pipe 内容 splice 到 socket。socket 侧最终使用内部标志 MSG\_SPLICE\_PAGES,该标志不允许用户态通过 sendmsg 直接传入,在系统调用边界会被剥离。 ```c /* * fs/splice.c 中 splice_to_socket 的入口。 * 它从 pipe 中取得页面引用,以零拷贝方式交给 socket 发送路径。 */ ssize_t splice_to_socket(struct pipe_inode_info *pipe, struct file *out, loff_t *ppos, size_t len, unsigned int flags) { struct socket *sock = sock_from_file(out); struct bio_vec bvec[16]; struct msghdr msg = {}; ssize_t ret = 0; size_t spliced = 0; pipe_lock(pipe); while (len > 0) { unsigned int head, tail, bc = 0; size_t remain = len; struct pipe_buffer *buf; size_t seg; ... tail = pipe->tail; buf = pipe_buf(pipe, tail); seg = min_t(size_t, remain, buf->len); bvec_set_page(&bvec[bc++], buf->page, seg, buf->offset); /* * 后续代码把 pipe buffer 中的页面转换为 bio_vec, * 设置 MSG_SPLICE_PAGES,并调用 sock_sendmsg。 */ msg.msg_flags = MSG_SPLICE_PAGES; iov_iter_bvec(&msg.msg_iter, ITER_SOURCE, bvec, bc, len - remain); ret = sock_sendmsg(sock, &msg); ... } out: pipe_unlock(pipe); return spliced ?: ret; } ``` 可以看到内核会在 pipe 中逐个取得 pipe\_buffer,设置 iov\_iter,并通过 socket 的 sendmsg 进入协议层。 ### sk\_buff 与 skb\_shared\_info 网络栈用 sk\_buff 表示报文。sk\_buff 头部中保存线性缓冲区的指针和长度,随后通过 skb\_end\_pointer 得到 skb\_shared\_info,再通过 skb\_shared\_info.frags 管理页面分片,通过 frag\_list 链接更多 skb。 sk\_buff 和 skb\_shared\_info 的大致定义如下: ```c struct sk_buff { ... unsigned int len; unsigned int data_len; unsigned char *head, *data; sk_buff_data_t tail; sk_buff_data_t end; unsigned int truesize; refcount_t users; }; struct skb_shared_info { __u8 flags; __u8 meta_len; __u8 nr_frags; __u8 tx_flags; struct sk_buff *frag_list; ... skb_frag_t frags[MAX_SKB_FRAGS]; }; ``` 其中 skb->data ~ skb->tail 之间的区域是线性数据区,然后通过 skb\_end\_pointer(skb) 计算得到skb->head + skb->end 得到 skb\_shared\_info 的位置,skb\_shared\_info 用于管理 sk\_buff 的共享数据区,sk\_buff的线性数据区和shard\_info之间的布局关系如下图所示: 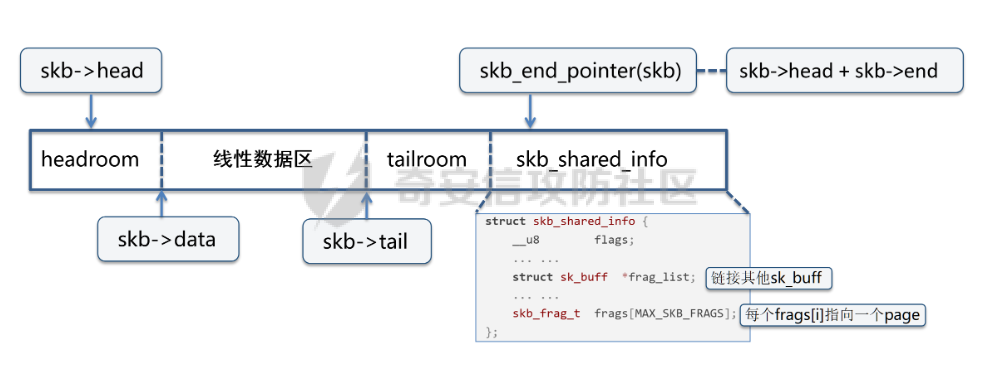 可以看到 sk\_buff 有三种类型的数据区: - 线性数据区; - skb\_shared\_info.frags\[\] 数组管理的页面; - skb\_shared\_info.frag\_list 链接的其他sk\_buff; ### [](http://localhost:4000/2026/06/29/CVE-2026-43503/#SKBFL-SHARED-FRAG "SKBFL&#95;SHARED&#95;FRAG")SKBFL\_SHARED\_FRAG skb\_shared\_info.flags 中定义了几类标志。SKBFL\_SHARED\_FRAG 的语义是该 skb 至少有一个 frag 可能被外部实体改写,后续代码不能直接原地写入这些分片: 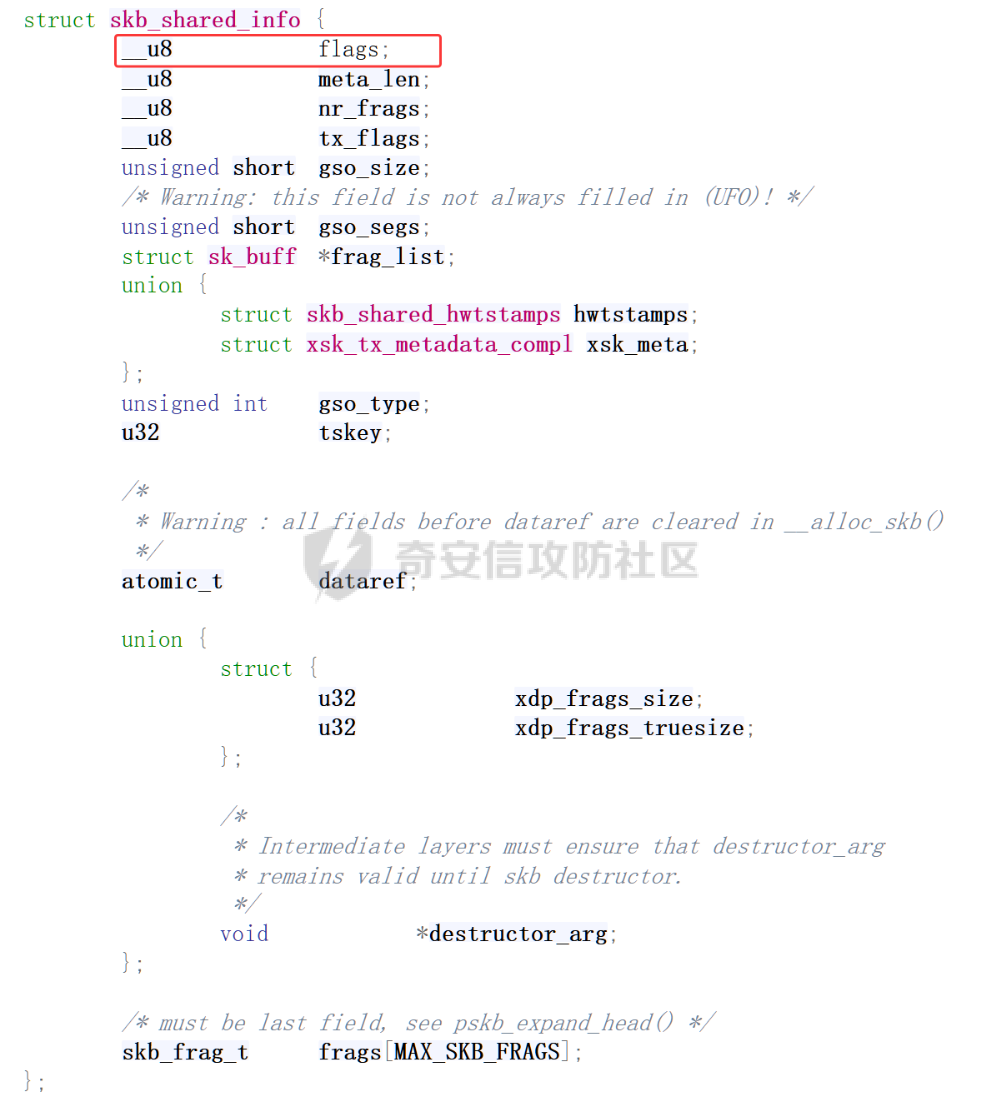 ```c enum { SKBFL_ZEROCOPY_ENABLE = BIT(0), /* * This indicates at least one fragment might be overwritten * (as in vmsplice(), sendfile() ...) * If we need to compute a TX checksum, we'll need to copy * all frags to avoid possible bad checksum */ SKBFL_SHARED_FRAG = BIT(1), SKBFL_PURE_ZEROCOPY = BIT(2), SKBFL_DONT_ORPHAN = BIT(3), SKBFL_MANAGED_FRAG_REFS = BIT(4), }; ``` 需要原地写入 skb 数据的代码,通常先调用 skb\_has\_shared\_frag 检查标志,再决定是否通过 skb\_cow\_data 等函数建立私有副本: ```c static inline bool skb_has_shared_frag(const struct sk_buff *skb) { return skb_is_nonlinear(skb) && skb_shinfo(skb)->flags & SKBFL_SHARED_FRAG; } ``` 这里存在一条不变量:只要 skb 的 frags 引用了页缓存页、pipe 页或用户页,并且页面可能被其他主体改写,目标 skb 的 shared\_info.flags 就必须保留 SKBFL\_SHARED\_FRAG。任何只迁移 frags 描述符的辅助函数都必须同时迁移该标志。 ### 发送路径如何设置该标志 TCP 和 UDP 的发送路径在调用 skb\_splice\_from\_iter 后,会在未设置 MSG\_NO\_SHARED\_FRAGS 时给 skb 打上 SKBFL\_SHARED\_FRAG。TCP 侧位于 tcp\_sendmsg\_locked,UDP 侧位于 IPv4 和 IPv6 的 append 路径。 ```c /* * net/ipv4/tcp.c 中的简化片段。 * skb_splice_from_iter 把 pipe 页面挂入 skb 的 frags。 */ err = skb_splice_from_iter(skb, &msg->msg_iter, copy); if (err < 0) goto do_error; copy = err; if (!(flags & MSG_NO_SHARED_FRAGS)) skb_shinfo(skb)->flags |= SKBFL_SHARED_FRAG; ``` ```c /* * net/ipv4/ip_output.c 中的简化片段。 * UDP 发送路径同样在 splice 后设置共享分片标志。 */ err = skb_splice_from_iter(skb, &msg->msg_iter, copy); if (err < 0) goto error; copy = err; if (!(flags & MSG_NO_SHARED_FRAGS)) skb_shinfo(skb)->flags |= SKBFL_SHARED_FRAG; ``` 因此,攻击者通过 sendfile 或 splice 把一个 root 拥有、可读文件的页缓存页送入 UDP 或 TCP socket 时,初始 skb 的 frags 指向该文件的页缓存页,并且 flags 中带有 SKBFL\_SHARED\_FRAG。 ### GRO GRO 全称 Generic Receive Offload,位于 NAPI 收包路径。它把属于同一数据流的多个小报文聚合为一个 skb,再交给上层协议栈。skb\_gro\_receive 负责把新收到的 skb 合并到已有聚合包 p 中。该函数尽量只移动页面描述符,避免复制报文数据。 ```c int skb_gro_receive(struct sk_buff *p, struct sk_buff *skb); ``` 聚合时可以走三条路径:直接迁移 frags、把 skb 头部所在页面也作为 frag 迁移、把整个 skb 挂入 p 的 frag\_list。前两条路径只移动或复制 frag 描述符,第三条路径让 p 共享 skb 本身。无论哪条路径,p 或 lp 都可能继续引用 skb 原有的页缓存页面。 [](http://localhost:4000/2026/06/29/CVE-2026-43503/#%E6%BC%8F%E6%B4%9E%E5%88%86%E6%9E%90 "漏洞分析")漏洞分析 ---------------------------------------------------------------------------------------------------- 漏洞涉及的核心函数是 [skb\_gro\_receive](https://elixir.bootlin.com/linux/v7.0/C/ident/skb_gro_receive) ,其功能是把新收到的 skb 的有效载荷合并到已有 GRO 聚合包 p 中,尽量只转移内存页描述符,避免复制报文数据。 函数原型如下,其中 p 表示已有的 GRO 聚合包,skb 表示新到达、准备合并的包: ```c int skb_gro_receive(struct sk_buff *p, struct sk_buff *skb); ``` 该函数大致分成四步: - 检查是否允许合并 - 确定 skb 中哪部分是需要合并的负载 - 选择一种内存合并方式 - 更新 p 的长度、段数和内存记账 该函数的完整代码如下: ```c int skb_gro_receive(struct sk_buff *p, struct sk_buff *skb) { struct skb_shared_info *pinfo, *skbinfo = skb_shinfo(skb); unsigned int offset = skb_gro_offset(skb); unsigned int headlen = skb_headlen(skb); unsigned int len = skb_gro_len(skb); unsigned int delta_truesize; unsigned int new_truesize; struct sk_buff *lp; int segs; /* Do not splice page pool based packets w/ non-page pool * packets. This can result in reference count issues as page * pool pages will not decrement the reference count and will * instead be immediately returned to the pool or have frag * count decremented. */ if (p->pp_recycle != skb->pp_recycle) return -ETOOMANYREFS; if (unlikely(p->len + len >= netif_get_gro_max_size(p->dev, p) || NAPI_GRO_CB(skb)->flush)) return -E2BIG; if (unlikely(p->len + len >= GRO_LEGACY_MAX_SIZE)) { if (NAPI_GRO_CB(skb)->proto != IPPROTO_TCP || p->encapsulation) return -E2BIG; } segs = NAPI_GRO_CB(skb)->count; lp = NAPI_GRO_CB(p)->last; pinfo = skb_shinfo(lp); if (headlen <= offset) { skb_frag_t *frag; skb_frag_t *frag2; int i = skbinfo->nr_frags; int nr_frags = pinfo->nr_frags + i; if (nr_frags > MAX_SKB_FRAGS) goto merge; offset -= headlen; pinfo->nr_frags = nr_frags; skbinfo->nr_frags = 0; frag = pinfo->frags + nr_frags; frag2 = skbinfo->frags + i; do { *--frag = *--frag2; } while (--i); skb_frag_off_add(frag, offset); skb_frag_size_sub(frag, offset); /* all fragments truesize : remove (head size + sk_buff) */ new_truesize = SKB_TRUESIZE(skb_end_offset(skb)); delta_truesize = skb->truesize - new_truesize; skb->truesize = new_truesize; skb->len -= skb->data_len; skb->data_len = 0; NAPI_GRO_CB(skb)->free = NAPI_GRO_FREE; goto done; } else if (skb->head_frag) { int nr_frags = pinfo->nr_frags; skb_frag_t *frag = pinfo->frags + nr_frags; struct page *page = virt_to_head_page(skb->head); unsigned int first_size = headlen - offset; unsigned int first_offset; if (nr_frags + 1 + skbinfo->nr_frags > MAX_SKB_FRAGS) goto merge; first_offset = skb->data - (unsigned char *)page_address(page) + offset; pinfo->nr_frags = nr_frags + 1 + skbinfo->nr_frags; skb_frag_fill_page_desc(frag, page, first_offset, first_size); memcpy(frag + 1, skbinfo->frags, sizeof(*frag) * skbinfo->nr_frags); /* We dont need to clear skbinfo->nr_frags here */ new_truesize = SKB_DATA_ALIGN(sizeof(struct sk_buff)); delta_truesize = skb->truesize - new_truesize; skb->truesize = new_truesize; NAPI_GRO_CB(skb)->free = NAPI_GRO_FREE_STOLEN_HEAD; goto done; } merge: /* sk ownership - if any - completely transferred to the aggregated packet */ skb->destructor = NULL; skb->sk = NULL; delta_truesize = skb->truesize; if (offset > headlen) { unsigned int eat = offset - headlen; skb_frag_off_add(&skbinfo->frags[0], eat); skb_frag_size_sub(&skbinfo->frags[0], eat); skb->data_len -= eat; skb->len -= eat; offset = headlen; } __skb_pull(skb, offset); if (NAPI_GRO_CB(p)->last == p) skb_shinfo(p)->frag_list = skb; else NAPI_GRO_CB(p)->last->next = skb; NAPI_GRO_CB(p)->last = skb; __skb_header_release(skb); lp = p; done: NAPI_GRO_CB(p)->count += segs; p->data_len += len; p->truesize += delta_truesize; p->len += len; if (lp != p) { lp->data_len += len; lp->truesize += delta_truesize; lp->len += len; } NAPI_GRO_CB(skb)->same_flow = 1; return 0; } ``` 首先该函数对关键变量进行赋值: ```c unsigned int offset = skb_gro_offset(skb); unsigned int headlen = skb_headlen(skb); unsigned int len = skb_gro_len(skb); ``` 它们的含义分别是: - offset:GRO 协议解析已经走到的位置 - headlen:skb 整个线性数据区的长度 - len:从 offset 开始,真正需要并入 p 的长度 假设新包布局如下,sk\_buff 的线性数据区中包含协议头和数据,其中前面的协议头已经解析过,通常不需要重复放进聚合包,真正要合并的是 offset 后面的数据,其中skb\_gro\_len() 的定义就是 skb->len - offset: 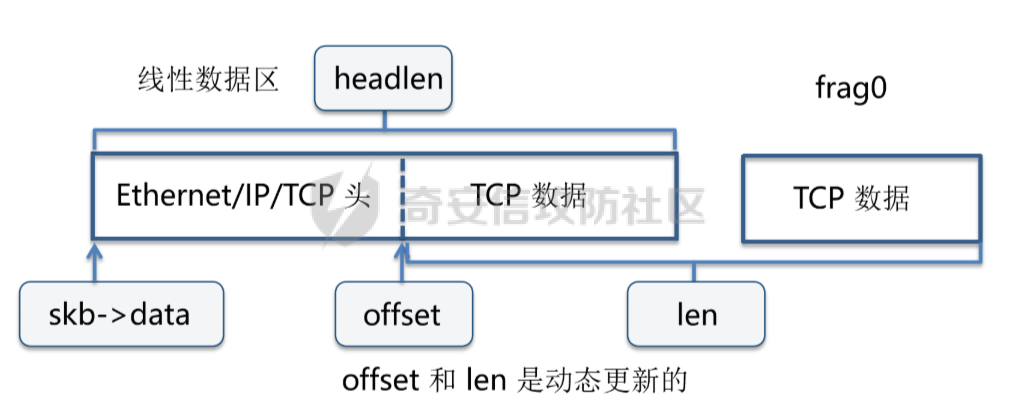 接下来首先进行合并前的检查,要求包括: 1. 属性必须一致; 2. 聚合结果不能过大; 3. 超过 GRO\_LEGACY\_MAX\_SIZE 时,只对符合条件的 TCP 包放宽限制; ```c if (p->pp_recycle != skb->pp_recycle) return -ETOOMANYREFS; if (unlikely(p->len + len >= netif_get_gro_max_size(p->dev, p) || NAPI_GRO_CB(skb)->flush)) return -E2BIG; if (unlikely(p->len + len >= GRO_LEGACY_MAX_SIZE)) { if (NAPI_GRO_CB(skb)->proto != IPPROTO_TCP || p->encapsulation) return -E2BIG; } ``` 之后找到实际追加位置,p 可能已经通过 frag\_list 链接了其他 skb,lp 是当前聚合结构的最后一个 skb: ```c segs = NAPI_GRO_CB(skb)->count; lp = NAPI_GRO_CB(p)->last; pinfo = skb_shinfo(lp); ``` 接下来分三种方式进行聚合,其中第一种方式是直接转移 frags,当 headlen <= offset 的时候,说明offset大于整个线性数据区的长度,说明当前要处理的数据在frags中或者frag\_list中,首先检查p还能否装得下skb,如果能则直接赋值 frag 为 p 的尾部,frag2 为 skb 的第一个frag,然后通过while循环进行赋值。 而第一个漏洞点也就出现在这里,GRO的过程中只复制了 frag,却没有同步 skb\_shared\_info 中的 flags 的 SKBFL\_SHARED\_FRAG 标志位。 ```c if (headlen <= offset) { skb_frag_t *frag; skb_frag_t *frag2; int i = skbinfo->nr_frags; // 待合并的skb的frag的数量 int nr_frags = pinfo->nr_frags + i; // 计算聚合之后总的frag的数量 if (nr_frags > MAX_SKB_FRAGS) // 检查 p 的 frags 数组能否完全装得下 goto merge; offset -= headlen; pinfo->nr_frags = nr_frags; skbinfo->nr_frags = 0; frag = pinfo->frags + nr_frags; // p 的尾部 frag2 = skbinfo->frags + i; // skb 的第一个 frag do { // 通过赋值实现迁移 *--frag = *--frag2; // 【漏洞点1】 } while (--i); skb_frag_off_add(frag, offset); skb_frag_size_sub(frag, offset); /* all fragments truesize : remove (head size + sk_buff) */ new_truesize = SKB_TRUESIZE(skb_end_offset(skb)); delta_truesize = skb->truesize - new_truesize; skb->truesize = new_truesize; skb->len -= skb->data_len; skb->data_len = 0; NAPI_GRO_CB(skb)->free = NAPI_GRO_FREE; goto done; } ``` 下面再看第二个聚合方式,该分支的条件是 headlen > offset,即存在线性数据需要聚合,同时 skb->head\_frag 不为NULL,表示skb->head 指向的线性缓冲区是否来自一个 page fragment,而不是普通的 kmalloc 内存,则将其线性数据区的数据也放到 p 的一个frag中,之后再将 skb 的其他 frag 复用过来。 可以看到方式二犯了和方式一同样的错误,都是只复制了 frag,却没有同步 skb\_shared\_info 中的 flags 的 SKBFL\_SHARED\_FRAG 标志位。 ```c } else if (skb->head_frag) { int nr_frags = pinfo->nr_frags; skb_frag_t *frag = pinfo->frags + nr_frags; struct page *page = virt_to_head_page(skb->head); unsigned int first_size = headlen - offset; unsigned int first_offset; // 同样计算能否装得下 if (nr_frags + 1 + skbinfo->nr_frags > MAX_SKB_FRAGS) goto merge; first_offset = skb->data - (unsigned char *)page_address(page) + offset; // 更新nr_frags,原nr_frags + 线性数据区占一个frag + skb的frags pinfo->nr_frags = nr_frags + 1 + skbinfo->nr_frags; // 拷贝 skb 的线性数据区 skb_frag_fill_page_desc(frag, page, first_offset, first_size); // 拷贝 skb 的 frag memcpy(frag + 1, skbinfo->frags, sizeof(*frag) * skbinfo->nr_frags); // 【漏洞点2】 /* We dont need to clear skbinfo->nr_frags here */ new_truesize = SKB_DATA_ALIGN(sizeof(struct sk_buff)); delta_truesize = skb->truesize - new_truesize; skb->truesize = new_truesize; NAPI_GRO_CB(skb)->free = NAPI_GRO_FREE_STOLEN_HEAD; goto done; } ``` 然后看第三种聚合方式,当不满足前两种分支条件或者 p 中放不下 skb 的 frags 的情况下都会走第三种聚合方式,此时会尝试将 skb 链接到 p 的 frag\_list 上,然后更新 lp 为 p: ```c merge: /* sk ownership - if any - completely transferred to the aggregated packet */ skb->destructor = NULL; skb->sk = NULL; delta_truesize = skb->truesize; if (offset > headlen) { unsigned int eat = offset - headlen; skb_frag_off_add(&skbinfo->frags[0], eat); skb_frag_size_sub(&skbinfo->frags[0], eat); skb->data_len -= eat; skb->len -= eat; offset = headlen; } __skb_pull(skb, offset); if (NAPI_GRO_CB(p)->last == p) skb_shinfo(p)->frag_list = skb; else NAPI_GRO_CB(p)->last->next = skb; NAPI_GRO_CB(p)->last = skb; __skb_header_release(skb); lp = p; ``` 当上述聚合动作完成之后,如果被聚合的sk\_buff中携带了来自文件的page cache,那么新聚合的sk\_buff中会复用这个page cache,且其shared\_info.flags中没有设置 SKBFL\_SHARED\_FRAG 标志位为 true。 这会导致极其严重的危害,当该 sk\_buff 进入到写路径时由于内核没有看到 SKBFL\_SHARED\_FRAG 标志会误认为该 sk\_buff 携带的所有页面均是私有的,从而直接对外部文件的 page cache 进行写入,从而达到越权写文件的效果。要知道在该漏洞场景下 /etc/passwd 是可以被普通用户以只读方式打开获得文件描述符并利用该漏洞篡改其 page cache 的,有了越权写入 /etc/passwd 的能力后攻击者可以注册任意特权用户并完成提权。 漏洞修复 ---- 漏洞的补丁如下,我们仅对第一处修复进行分析,可以看到在三种聚合方式的汇合处done进行修补,首先同步了 p 的标志位,当 lp 和 p 不相同的时候还要同步 lp 的标志位。 <https://git.kernel.org/pub/scm/linux/kernel/git/stable/linux.git/commit/?id=12401fcfb01f53ccc63ab0a3246570fe8f3105ee> 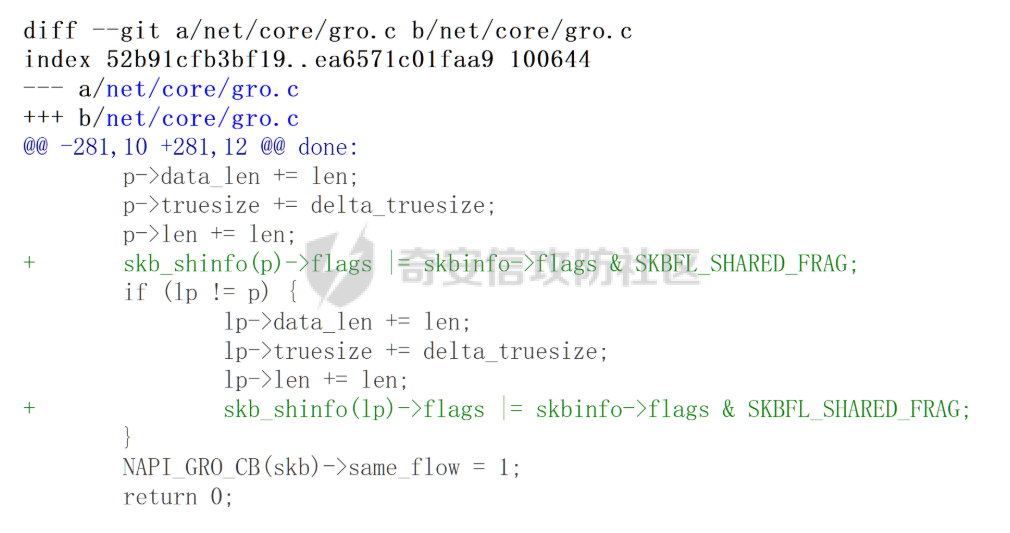 漏洞利用 ---- 完整利用需要 CAP\_NET\_ADMIN。在允许非特权用户命名空间的系统上,普通用户可以通过创建新的 user namespace 和 network namespace 获得该命名空间内的 CAP\_NET\_ADMIN,同时仍能读取初始挂载命名空间中的 /etc/passwd。 ### step1:将特权文件的页缓存页送入 skb 普通用户先构造一个 pipe。pipe 的第一个 buffer 放攻击者控制的 UDP/ESP 头等前导数据,后续 buffer 来自 /etc/passwd 等可读文件的页缓存。随后用户把 pipe 内容 splice 到 UDP socket。UDP 发送路径把 pipe 中的文件页缓存页挂到 skb 的 frags,并设置 SKBFL\_SHARED\_FRAG。初始 skb 尚未发生越权写,它只是持有文件页引用,符合零拷贝发送的正常语义。 示例如下: ```c int sock = socket(AF_INET, SOCK_DGRAM, IPPROTO_UDP); int filefd = open("/etc/passwd", O_RDONLY); int pipefd[2]; pipe(pipefd); write(pipefd[1], esp_udp_payload_header, sizeof(esp_udp_payload_header)); splice(filefd, NULL, pipefd[1], NULL, PAGE_SIZE * N, 0); splice(pipefd[0], NULL, sock, NULL, sizeof(esp_udp_payload_header) + PAGE_SIZE * N, 0); ``` 为了进入 ESP 输入路径,UDP payload 需要被内核识别为 ESP-in-UDP。前导 pipe buffer 提供 ESP 头,后续文件页 buffer 提供 ESP 密文区。接收 socket 需要配置 UDP encapsulation,使内核调用 xfrm4\_udp\_encap\_rcv 或 xfrm6\_udp\_encap\_rcv,最终进入 esp\_input。真正被原地写回的页面是后续文件页缓存页,ESP 头则可以位于攻击者控制的 pipe 页面中。 ### step2:让 frag 迁移路径丢失标志 一个直接可行的触发点是 netfilter 的包复制。攻击者配置 nft dup to local 或 xt\_TEE。nf\_dup\_ipv4 调用 pskb\_copy,修复前的 \_\_pskb\_copy\_fclone 复制 frags 描述符但不复制 SKBFL\_SHARED\_FRAG。复制后的 skb 与原始 skb 共享同一批文件页缓存页,却报告 skb\_has\_shared\_frag 为 false。 GRO 路径也属于同类触发点。若一个带有 SKBFL\_SHARED\_FRAG 的 skb 在接收路径被 skb\_gro\_receive 或 skb\_gro\_receive\_list 聚合,聚合包 p 或最后一个子 skb lp 在修复前同样丢失标志。该缺陷是否进入可利用写路径,取决于后续是否发生原地写,例如再经过 skb\_segment 或进入其他共享分片消费者。 ### step3:ESP 输入路径原地解密 esp\_input 需要把解密结果写回 skb。它会检查 skb 是否被克隆、是否为非线性、是否带 frag\_list,以及是否带共享分片标志。只有满足以下条件的 skb 才走免复制快路径:未克隆,且要么为线性 skb,要么为无 frag\_list、无共享分片标志的非线性 skb。其他情况调用 skb\_cow\_data 建立私有副本。 ```c if (!skb_cloned(skb)) { if (!skb_is_nonlinear(skb)) { nfrags = 1; goto skip_cow; } else if (!skb_has_frag_list(skb) && !skb_has_shared_frag(skb)) { nfrags = skb_shinfo(skb)->nr_frags; nfrags++; goto skip_cow; } } err = skb_cow_data(skb, 0, &trailer); if (err < 0) goto out; nfrags = err; skip_cow: ... sg_init_table(sg, nfrags); err = skb_to_sgvec(skb, sg, 0, skb->len); ... aead_request_set_crypt(req, sg, sg, elen + ivlen, iv); err = crypto_aead_decrypt(req); ``` 当 SKBFL\_SHARED\_FRAG 被错误清除后,esp\_input 看到的是一个未克隆、非线性、无 frag\_list、且 skb\_has\_shared\_frag 返回 false 的 skb,于是进入 skip\_cow。crypto\_aead\_decrypt 的源和目标使用同一个 scatterlist,AEAD 变换直接写回原 frag 页面。这些页面同时属于 /etc/passwd 的页缓存,内核在缺少写权限的情况下改写了 root 拥有文件的内容。 authencesn-ESN 路径还会在 esp\_input\_set\_header 和 esp\_input\_restore\_header 中调整 ESP 头附近的数据。该路径既进行头部回写,也执行原地解密,因此提交信息把这类写入称为 authencesn-ESN stray writes。 ### step4:从页缓存改写升级为本地提权 攻击者可以控制写入页缓存的内容。若目标文件是 /etc/passwd,攻击者可以改写 passwd 条目,增加一个 uid 为 0 的账户,或覆盖某个 root 账户的密码字段。之后通过 su 或登录流程完成提权。也可以选择 /etc/shadow、/etc/sudoers 或其他由特权进程读取的文件,具体取决于文件可读性和系统配置。 这一过程不需要对目标文件拥有写权限。写操作由内核网络栈在解密时执行,用户态 write 并未参与。这正是 confused-deputy 式的越权写入。 [](http://localhost:4000/2026/06/29/CVE-2026-43503/#%E6%80%BB%E7%BB%93 "总结")总结 ------------------------------------------------------------------------------ 本漏洞和 copy-fail、dirty-frag 是同类型漏洞,攻击者可以通过 splice 等系统调用将只读特权文件(如 /etc/passwd)的页缓存(page cache)传递到 skb 的 frag 中,然后利用 GRO 过程中没有同步SKBFL\_SHARED\_FRAG 标志位的漏洞,得到一个持有特权文件页缓存且SKBFL\_SHARED\_FRAG 标志位为false的sk\_buff,之后对这个sk\_buff进行数据的写入,从而达到篡改特权文件并进一步本地提权的目的。 参考资料 ---- - Linux 内核修复提交:net: skbuff: propagate shared-frag marker through frag-transfer helpers,<https://git.kernel.org/pub/scm/linux/kernel/git/stable/linux.git/commit/?id=12401fcfb01f53ccc63ab0a3246570fe8f3105ee> - NVD CVE-2026-43503,<https://nvd.nist.gov/vuln/detail/CVE-2026-43503> - CVE-2026-43284,xfrm: esp: avoid in-place decrypt on shared skb frags,<https://nvd.nist.gov/vuln/detail/CVE-2026-43284> - skb\_gro\_receive 在线源码,<https://elixir.bootlin.com/linux/v7.0/C/ident/skb_gro_receive>
发表于 2026-09-23 09:00:01
阅读 ( 11954 )
分类:
漏洞分析
1 推荐
收藏
0 条评论
q1ming
3 篇文章
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
温馨提示
您当前没有「奇安信攻防社区」的账号,注册后可获取更多的使用权限。
×
举报此文章
垃圾广告信息:
广告、推广、测试等内容
违规内容:
色情、暴力、血腥、敏感信息等内容
不友善内容:
人身攻击、挑衅辱骂、恶意行为
其他原因:
请补充说明
举报原因:
×
如果觉得我的文章对您有用,请随意打赏。你的支持将鼓励我继续创作!